背景
线性扫描算法:逐行反汇编(无法将数据和内容进行区分)
递归下降算法:根据一条指令是否被另一条指令引用来决定是否对其进行反汇编(难以准确定位)
正是因为这两种反汇编的机制和缺陷,所以才导致花指令的诞生
花指令简单说就是在代码中混入一些垃圾数据阻碍静态分析
常见指令
0xE8 call + 4字节偏移地址
0xE9 jmp + 4字节偏移地址
0xEB jmp + 2字节偏移地址
0xFF15 call + 4字节地址
0xFF25 jmp + 4字节地址
0xcc int 3
0xe2 loop
0x74 jz
0x75 jnz
快捷键 下面是与花指令相关的IDA快捷键
U:undefine,把代码转化为数据
C:把数据转化为代码
P:创建函数
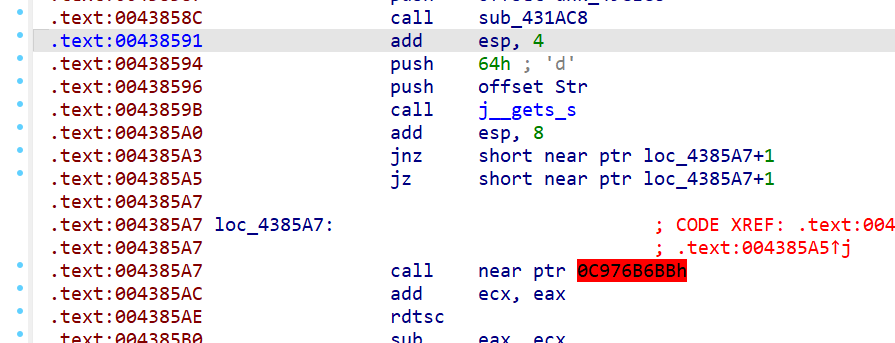
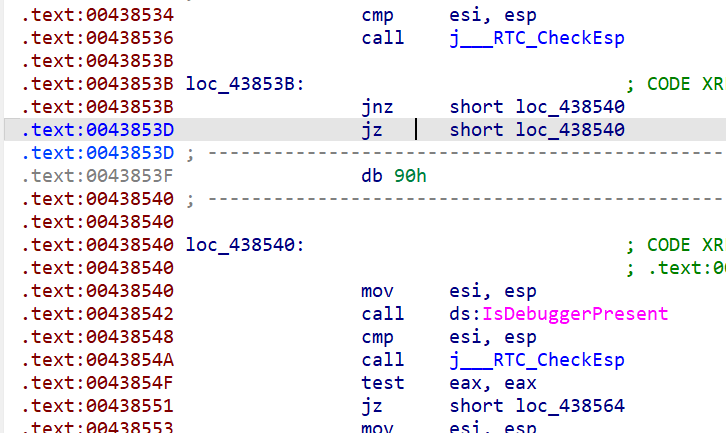
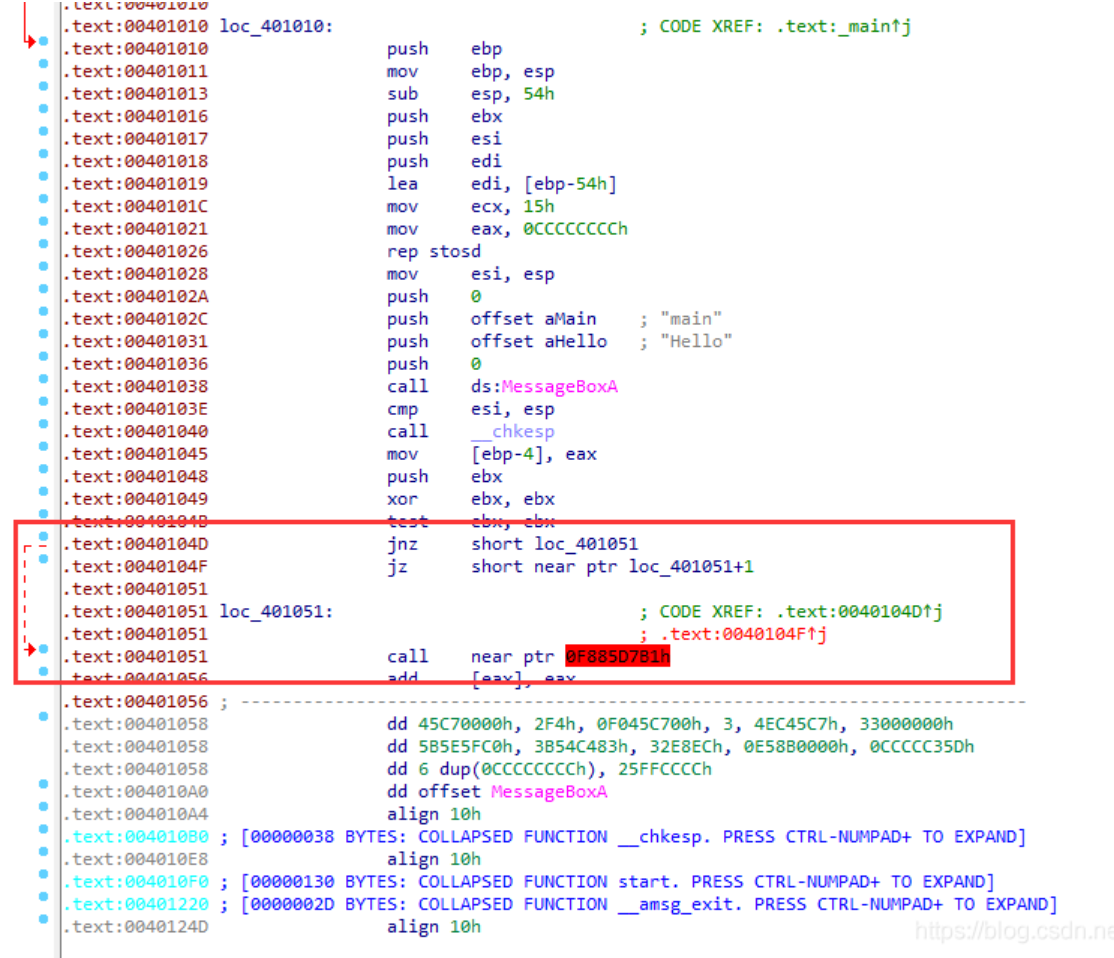
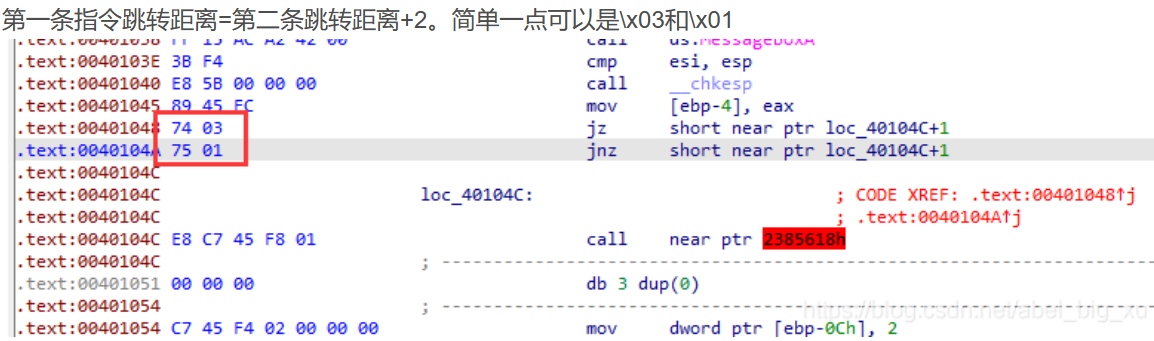
常规类型 1.jx+jnx(x可为e,z,l) jnz实际上是fake的,因为jz这个指令让ida认为jz下面的是另外一个分支
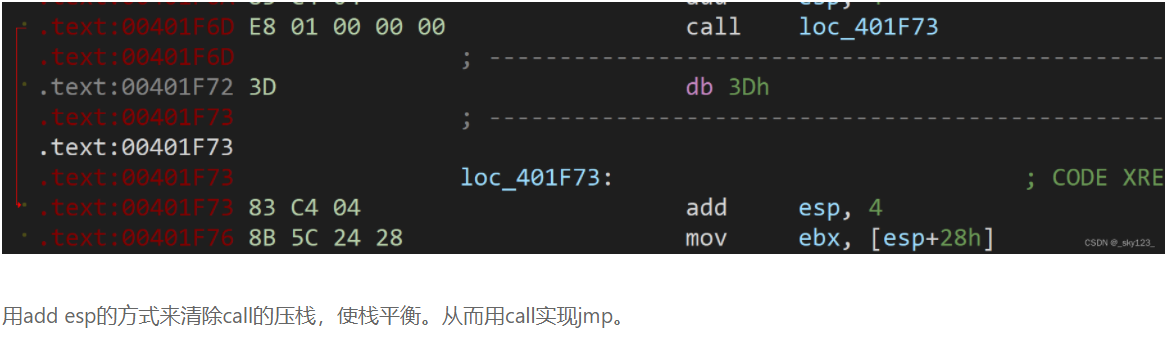
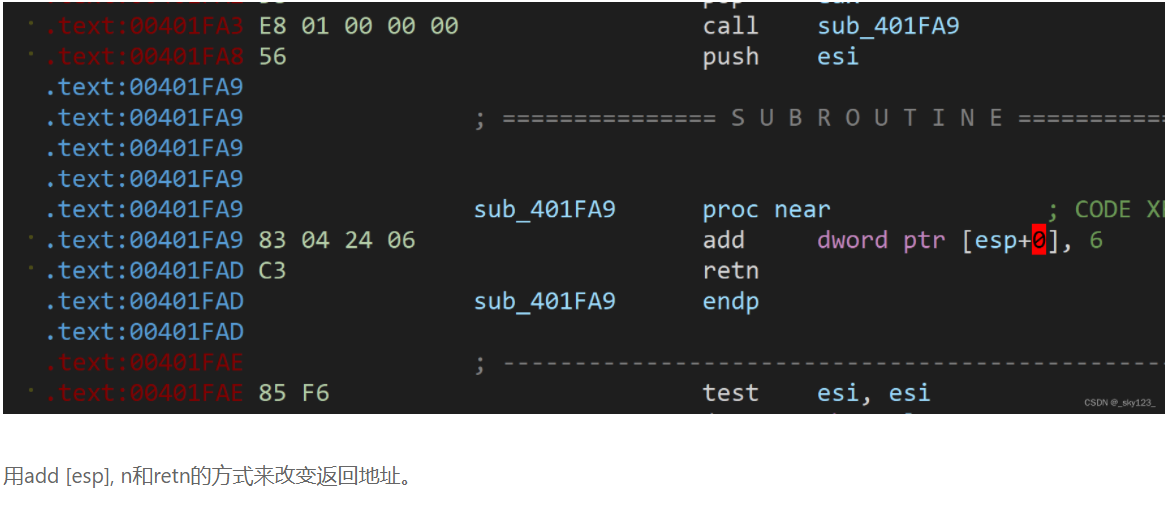
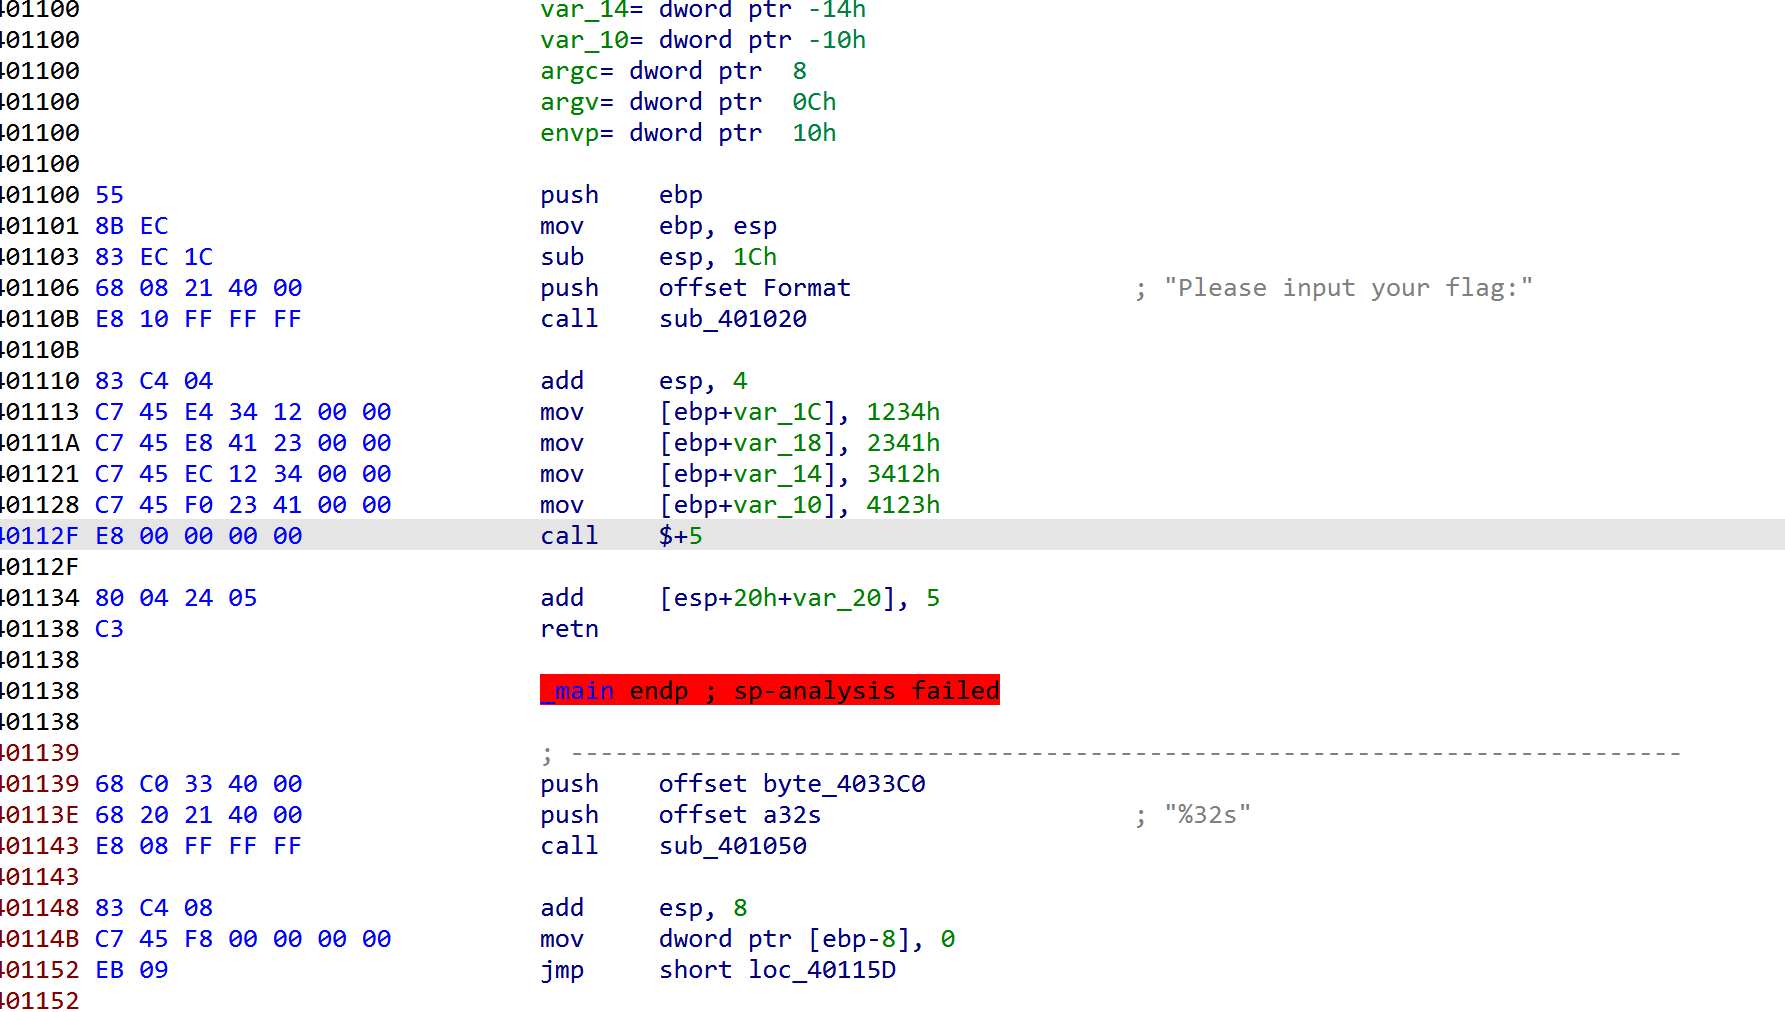
2.call + add [esp], n + retn 这里call指令,其实本质就是jmp&push 下一条指令的地址,但是这里只需要jmp指令,push这条指令是多余的,后续的add指令又会修改下一条指令的地址,造成爆红
易语言自带的花指令
1
2
3
4
004010BF . E8 00000000 call 1111.004010 C4 004010C4 /$ 830424 06 add dword ptr ss:[esp],0x6 004010C8 \. C3 retn 004010C9 B9 db B9
只需要将下面的特征码patch掉:E80000000083042406C3??
3.jmp XXX 题目练习:https://www.nssctf.cn/note/set/2970
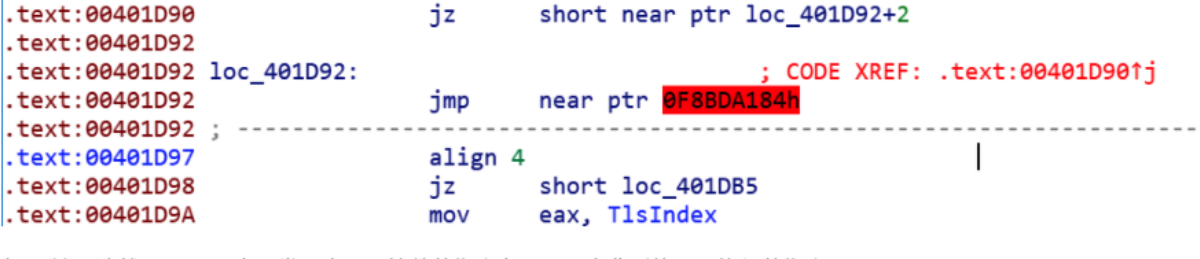
这也是一种常见的花指令,虚拟地址不可能那么大,实际是jmp指令对应的e9在搞鬼,ida会默认将e9后面的4个字节当成地址
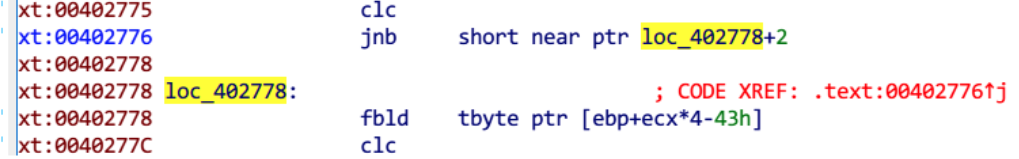
4.stx+jx clc是清除EFlags寄存器的carry位的标志,而jnb是根据cf==0时跳转的,然而jnb这个分支指令,ida又将后面的部分当成了另外的分支
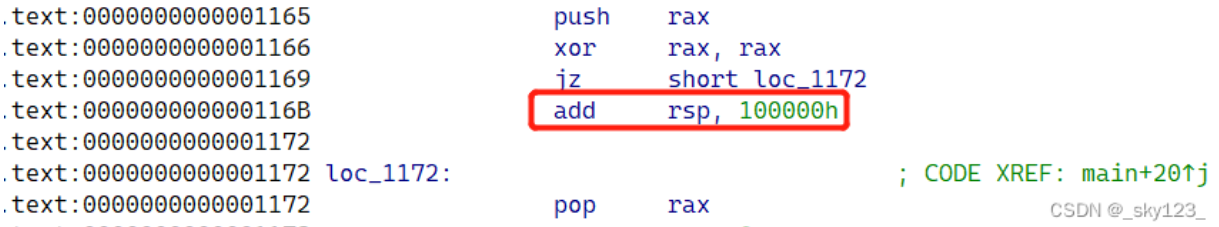
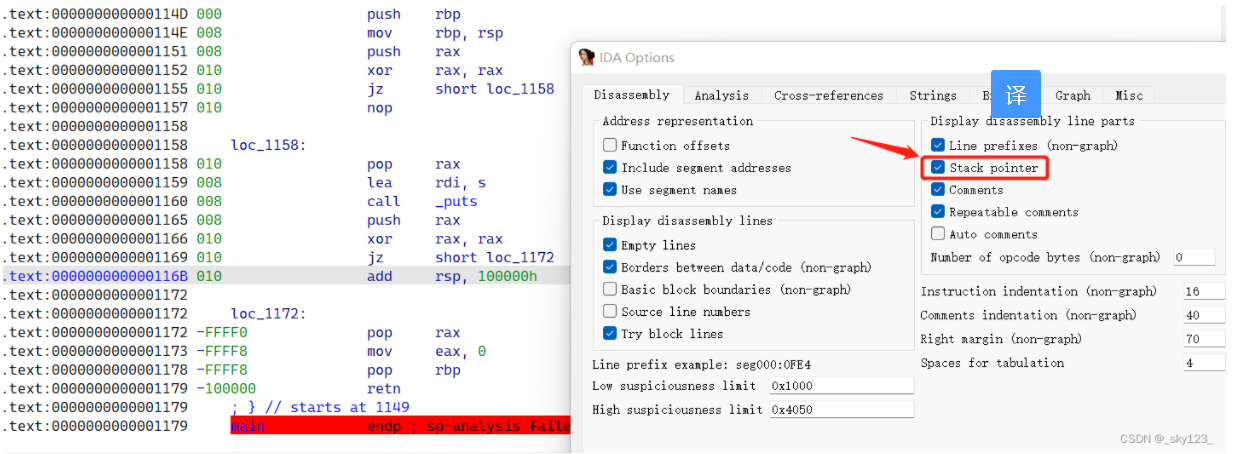
5.干扰栈分析 这条花指令会使 IDA 误以为 0x116B 处的指令可能会执行,导致 IDA 的栈分析出现错误
可以修改 ida 对栈的分析结果
在Options -> General菜单中勾上Stack pointer选项可以查看每行指令执行之前的栈帧大小
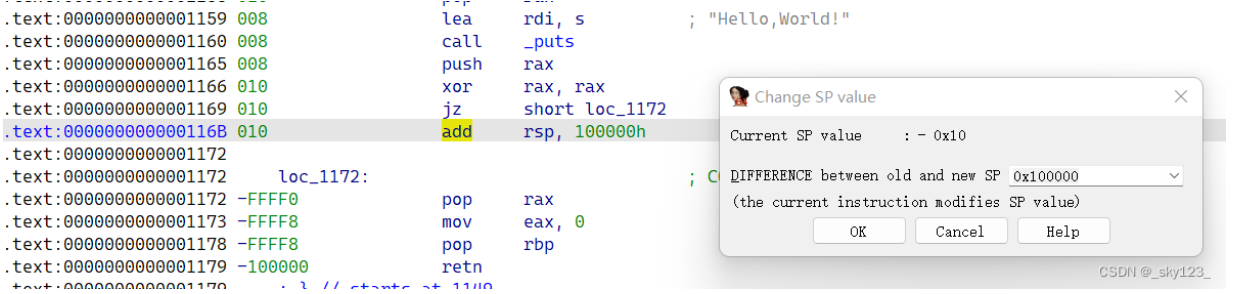
Alt + K 可以修改某条指令对栈指针的影响,从而消除这条花指令对反编译的影响。
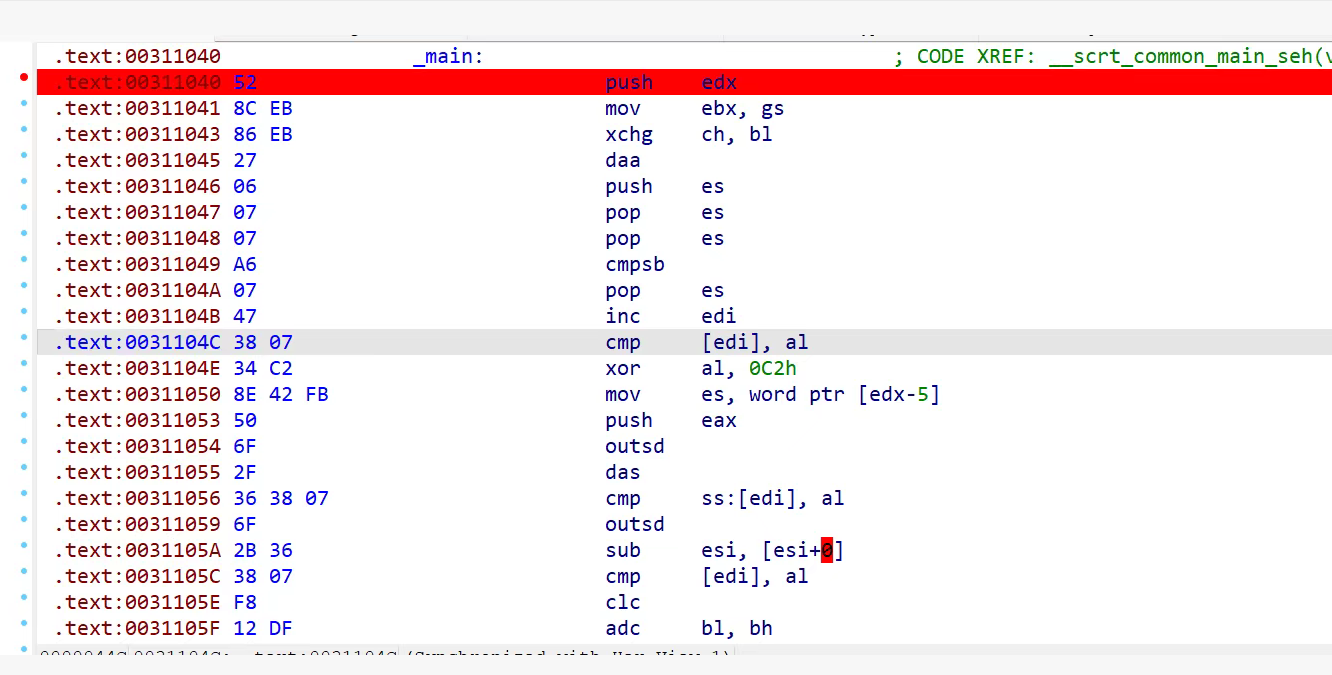
6.XOR加密代码字节 根据_main猜测是main,开头三个字节和push ebp;mov ebp,esp对应的16进制数55 8B EC异或一下刚好是7,所以猜测特定函数xor 7之后就能还原
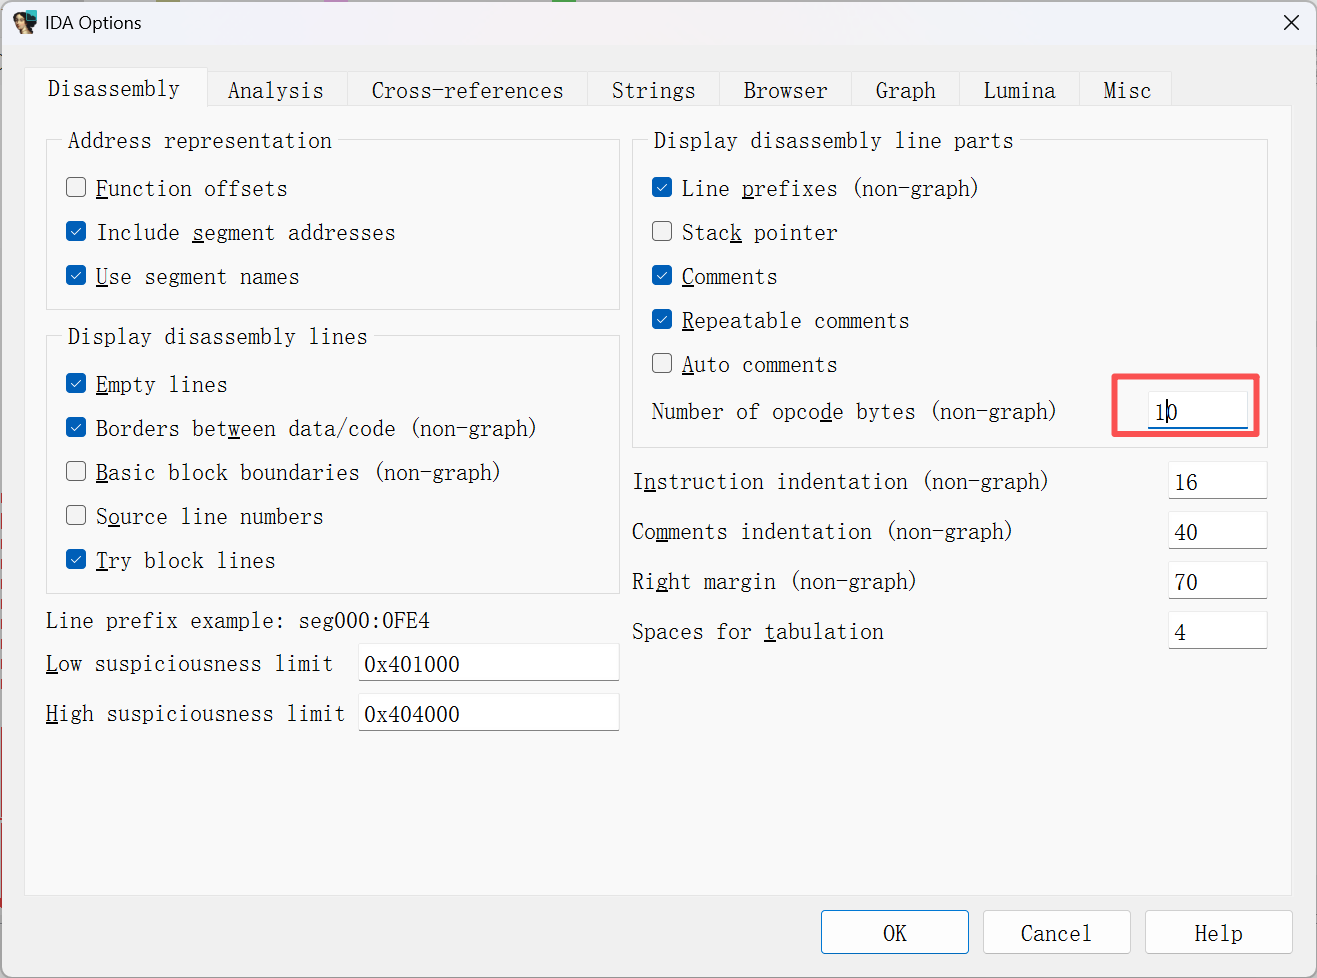
IDA Options->Disassembly窗口下可以修改显示的opcode
如何去除 nop单字节(E8/E9) 练习题目:https://www.nssctf.cn/problem/2313
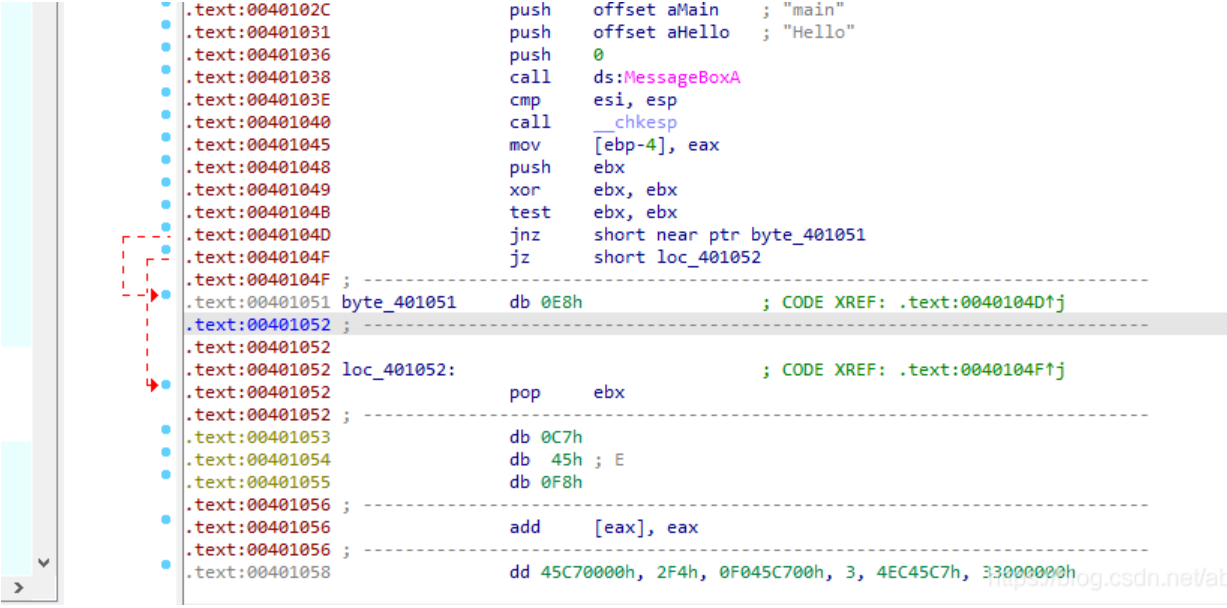
在0x401051设置为数据类型(快捷键D),将call 转成硬编码 E8 再将光标放到 db 0E8上 将E8改成 nop(90) 再次按C键(转化为代码类型)点yes 将硬编码修复成代码
然后向下逐⼀修复 将光标放置在黄色的行上 按C修复 直到没有黄色地址
最后全选函数,按P生成函数
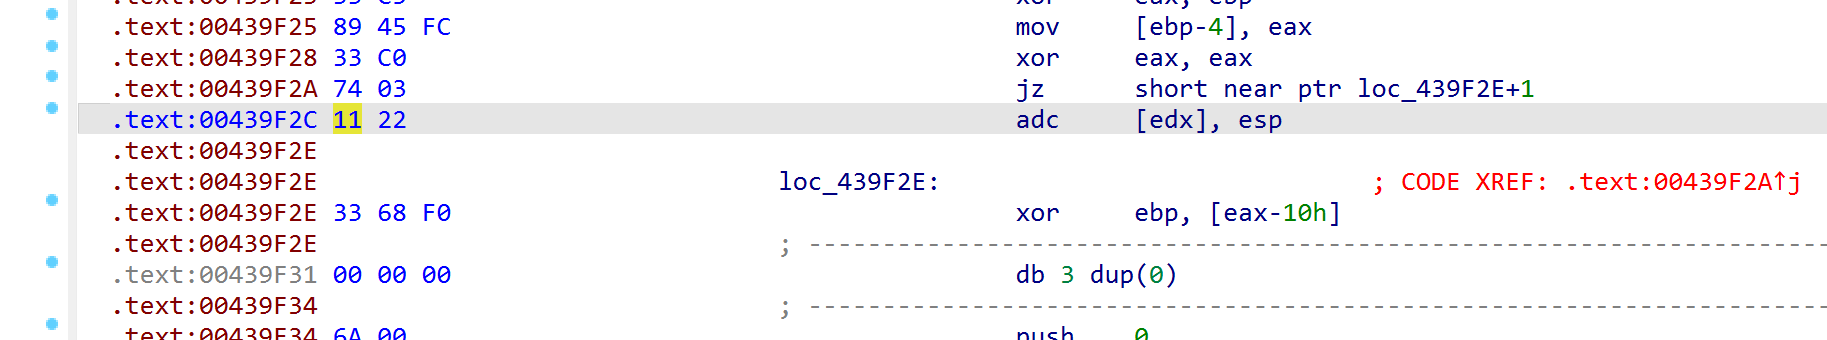
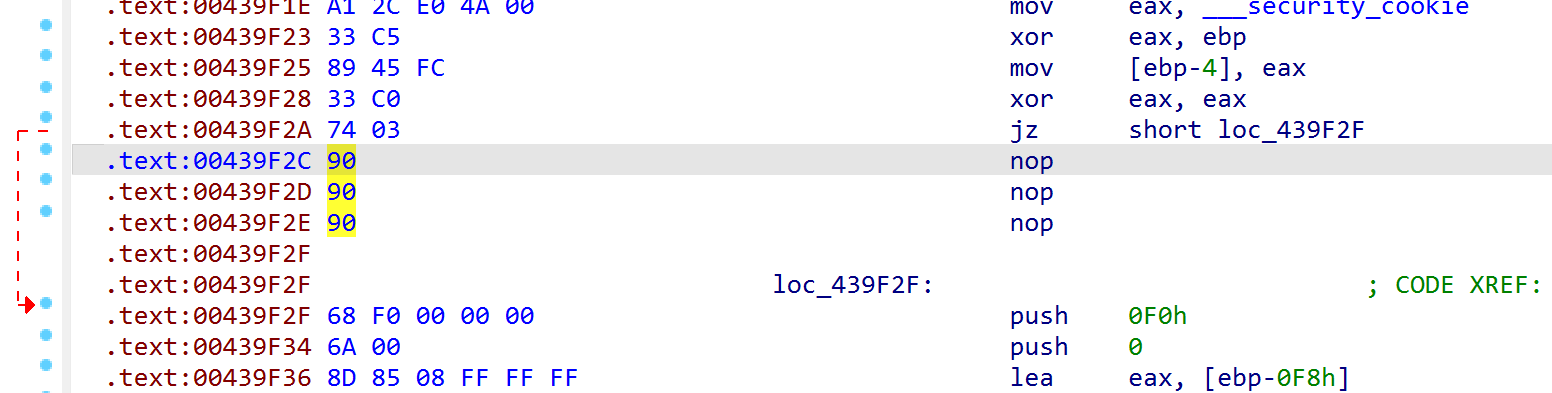
nop多余汇编 jz指令指向下一条指令中间
这个时候让jz正常分析,也就是把中间的nop
如果后面有数据没被分析为code,需要继续操作
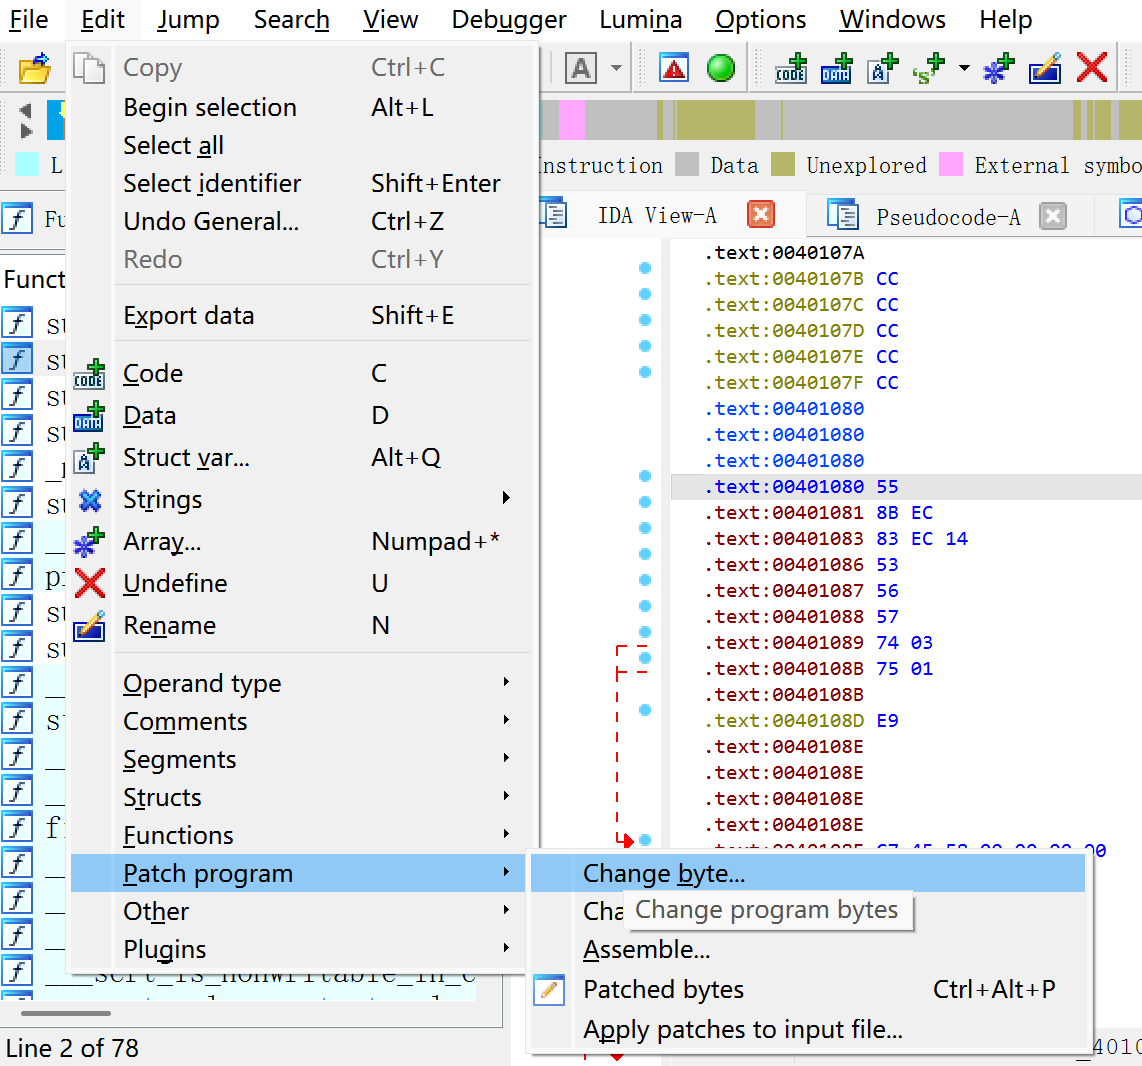
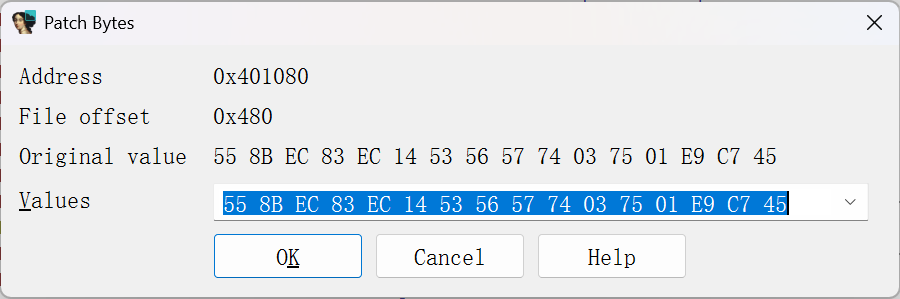
nop部分连续汇编 一般去菜单中的Edit->Patch program->Change byte修补单字节
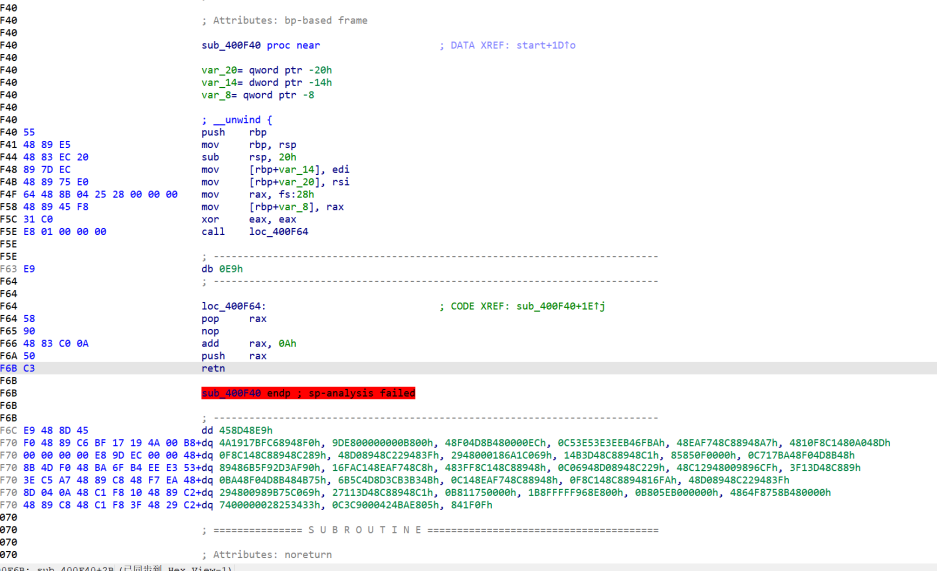
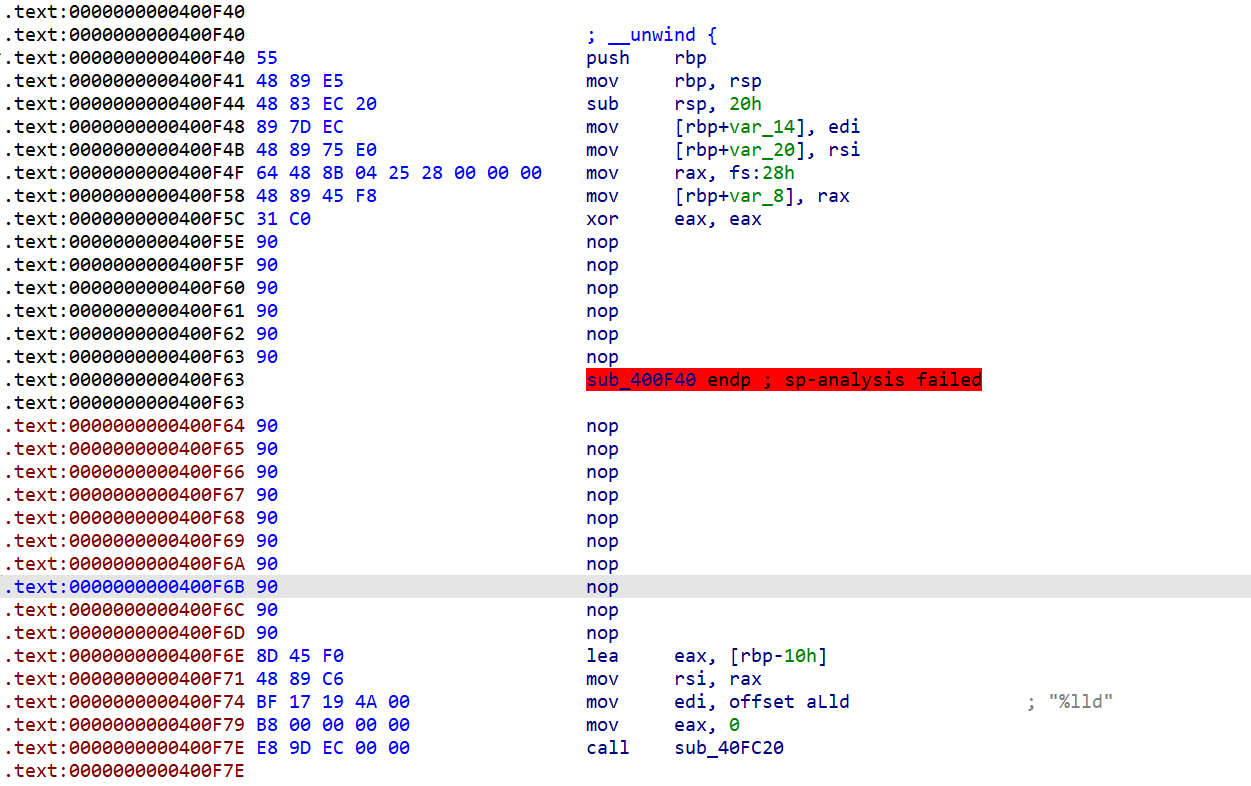
像下面这种红色标志离原函数有一定距离又是call+retn组合加上400f64又没什么用,可以都nop,这是一种暴力方法
nop完后看到有%lld,删除函数,修补函数即可反编译
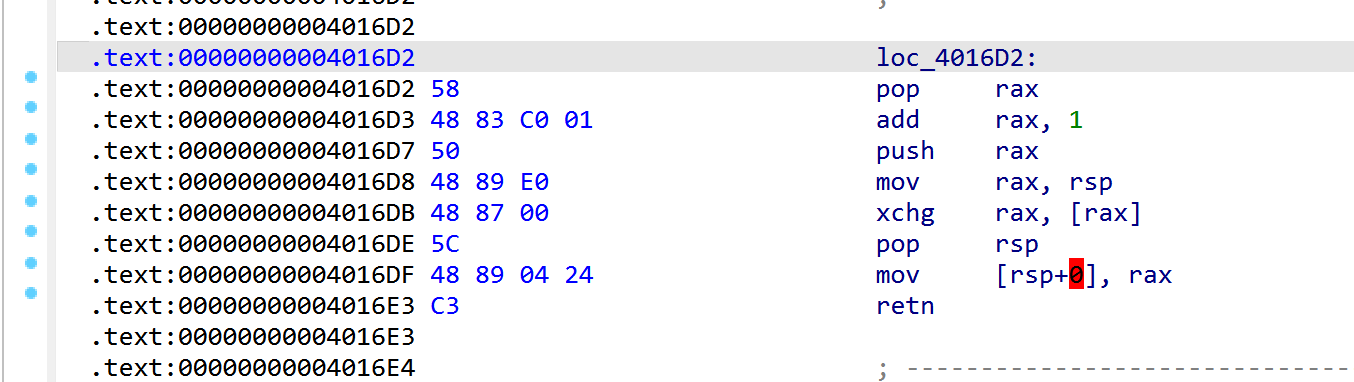
xchg很少用到,后面还有retn,主打不想要的直接全部nop
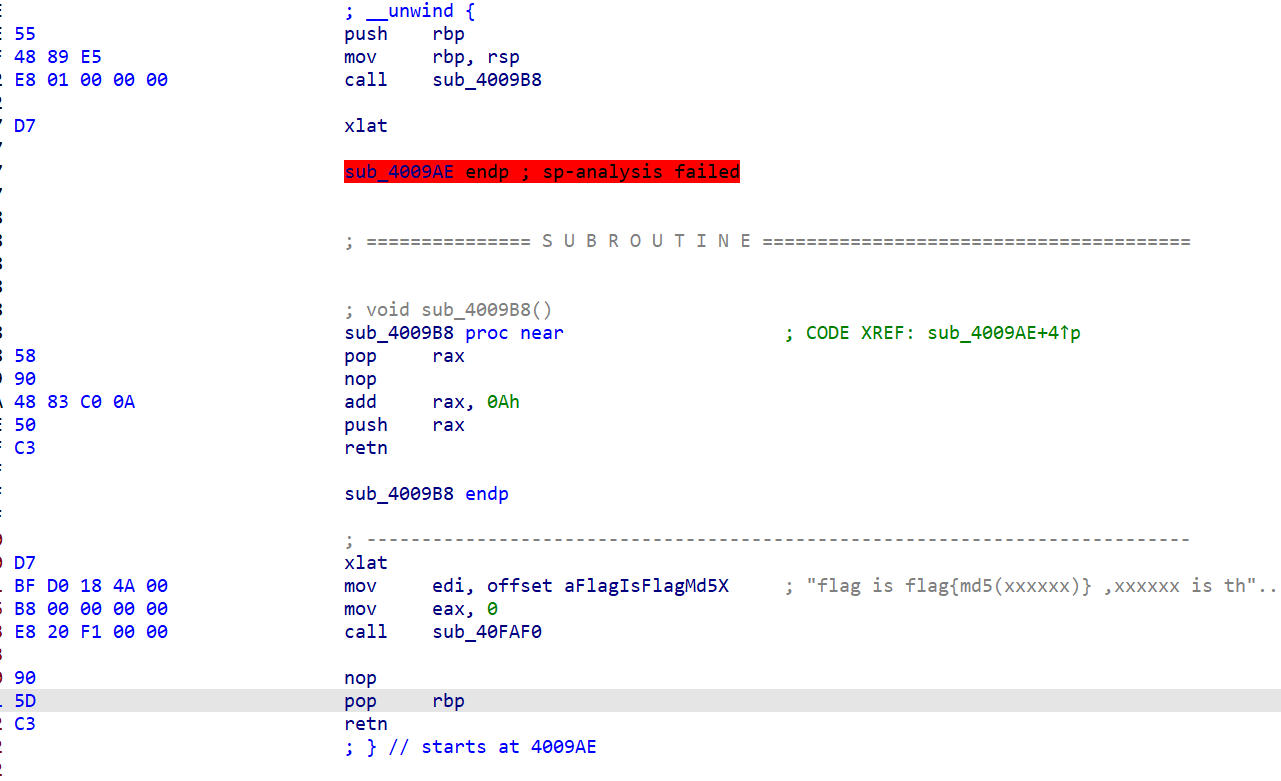
也可以先可以小范围的尝试,把call及下面一行先nop;发现不行,再从头把关键数据之前(D7,flag is上面那一行)也给nop掉,发现可以了
代码自动去花 出现大量花指令没有统一方法去除
集成脚本 下面脚本主要去除call相关花指令,jx + jnx花指令和stx + jx花指令
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
import regex as refrom idc import *import idcfrom keystone import *from capstone import *asmer = Ks(KS_ARCH_X86, KS_MODE_32) disasmer = Cs(CS_ARCH_X86, CS_MODE_32) def disasm (machine_code, addr=0 ): l = "" for i in disasmer.disasm(machine_code, addr): l += "{:8s} {};\n" .format (i.mnemonic, i.op_str) return l.strip('\n' ) def asm (asm_code, addr=0 ): l = b'' for i in asmer.asm(asm_code, addr)[0 ]: l += bytes ([i]) return l def check_call_to_jmp (call_insn_addr ): call_target = idc.get_operand_value(call_insn_addr, 0 ) if call_target not in range (start_ea, end_ea): return None idc.create_insn(call_target) if ida_bytes.get_bytes(call_target, idc.get_item_size(call_target)) == asm('add esp, 4' , call_target): return call_target + idc.get_item_size(call_target) if idc.print_insn_mnem(call_target) == 'pop' : return call_target + idc.get_item_size(call_target) insn = disasm(ida_bytes.get_bytes(call_target, idc.get_item_size(call_target)), call_target) if '[esp],' in insn and ('add' in insn or 'sub' in insn) and idc.get_operand_type(call_target, 1 ) == o_imm: idc.create_insn(call_target + idc.get_item_size(call_target)) if idc.print_insn_mnem(call_target + idc.get_item_size(call_target)) == 'retn' : return (call_insn_addr + 5 + (1 if idc.print_insn_mnem(call_target) == 'add' else -1 ) * idc.get_operand_value(call_target, 1 )) & 0xFFFFFFFF return None def check_jcc_to_jmp (jcc_insn_addr ): code1 = ida_bytes.get_bytes(jcc_insn_addr, idc.get_item_size(jcc_insn_addr)) next_insn_addr = jcc_insn_addr + idc.get_item_size(jcc_insn_addr) idc.create_insn(next_insn_addr) code2 = ida_bytes.get_bytes(next_insn_addr, idc.get_item_size(next_insn_addr)) if abs (code1[0 ] - code2[0 ]) == 1 and min (code1[0 ], code2[0 ]) % 2 == 0 and idc.get_operand_value(jcc_insn_addr, 0 ) == idc.get_operand_value(next_insn_addr, 0 ): return idc.get_operand_value(jcc_insn_addr, 0 ) code = ida_bytes.get_bytes(jcc_insn_addr, 12 ) print ("bbbbb" ) pattern_list = [ re.compile (rb"(?s)\x7C\x03\xEB\x03.\x74\xFB" ), re.compile (rb"(?s)\xEB\x07.\xEB\x01.\xEB\x04.\xEB\xF8." ), re.compile (rb"(?s)\xEB\x01." ) ] for pattern in pattern_list: match = re.match (pattern, code) if match != None and match .span()[1 ] != 0 : return jcc_insn_addr + match .span()[1 ] return None st_mnem_map = {'clc' : ['jnb' ], 'stc' : ['jb' ]} def check_st_to_jmp (st_insn_addr ): st_mnem = idc.print_insn_mnem(st_insn_addr) next_insn_addr = st_insn_addr + idc.get_item_size(st_insn_addr) idc.create_insn(next_insn_addr) if idc.print_insn_mnem(next_insn_addr) in st_mnem_map[st_mnem]: return idc.get_operand_value(next_insn_addr, 0 ) return None start_ea = 0x401000 end_ea = 0x4B9CD0 ea = start_ea while ea < end_ea: print ("aaa: " + hex (ea)) for i in range (ea, ea + 0x10 ): idc.del_items(i) if idc.create_insn(ea) == 0 : ea += 1 continue mnem = idc.print_insn_mnem(ea) if mnem == 'call' : jmp_target = check_call_to_jmp(ea) if jmp_target != None : assert jmp_target > ea print ("call: " + hex (ea)) print ("jmp target: " + hex (jmp_target)) if jmp_target > ea and abs (jmp_target - ea) <= 0x80 : ida_bytes.patch_bytes(ea, b"\x90" * (jmp_target - ea)) ea = jmp_target else : code = asm('jmp 0x%x' % (jmp_target), ea) ida_bytes.patch_bytes(ea, code) ea += len (code) continue elif mnem[0 ] == 'j' : jmp_target = check_jcc_to_jmp(ea) if jmp_target != None : print ("jcc: " + hex (ea)) assert jmp_target > ea if jmp_target > ea and abs (jmp_target - ea) <= 0x80 : ida_bytes.patch_bytes(ea, b"\x90" * (jmp_target - ea)) ea = jmp_target else : code = asm('jmp 0x%x' % (jmp_target), ea) ida_bytes.patch_bytes(ea, code) ea += len (code) continue elif mnem in st_mnem_map: jmp_target = check_st_to_jmp(ea) if jmp_target != None : print ("st: " + hex (ea)) assert jmp_target > ea if jmp_target > ea and abs (jmp_target - ea) <= 0x80 : ida_bytes.patch_bytes(ea, b"\x90" * (jmp_target - ea)) ea = jmp_target else : code = asm('jmp 0x%x' % (jmp_target), ea) ida_bytes.patch_bytes(ea, code) ea += len (code) continue ea += idc.get_item_size(ea) for _ in range (start_ea, end_ea): idc.del_items(_) idc.jumpto(0x004B8DE4 ) print ("finish" )
jx+jnx 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 from ida_bytes import get_bytes,patch_bytesstart= 0x401000 end = 0x422000 buf = get_bytes(start,end-start) def patch_at (p,ln ): global buf buf = buf[:p]+b"\x90" *ln+buf[p+ln:] fake_jcc=[] for opcode in range (0x70 ,0x7f ,2 ): pattern = chr (opcode)+"\x03" +chr (opcode|1 )+"\x01" fake_jcc.append(pattern.encode()) pattern = chr (opcode|1 )+"\x03" +chr (opcode)+"\x01" fake_jcc.append(pattern.encode()) print (fake_jcc)for pattern in fake_jcc: p = buf.find(pattern) while p != -1 : patch_at(p,5 ) p = buf.find(pattern,p+1 ) patch_bytes(start,buf) print ("Done" )
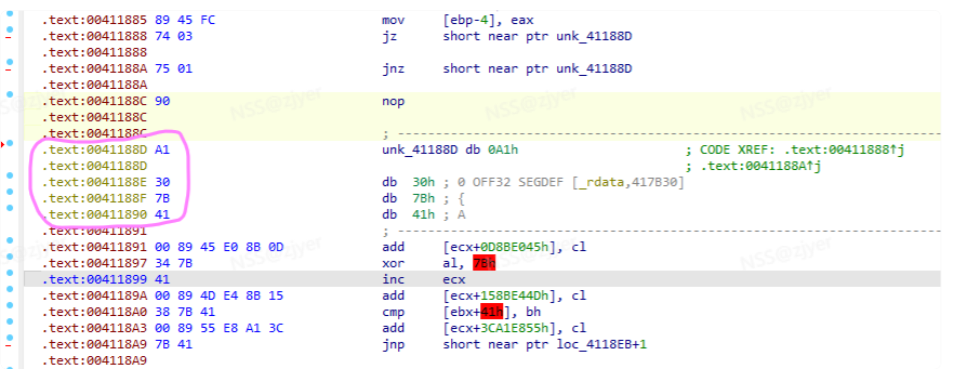
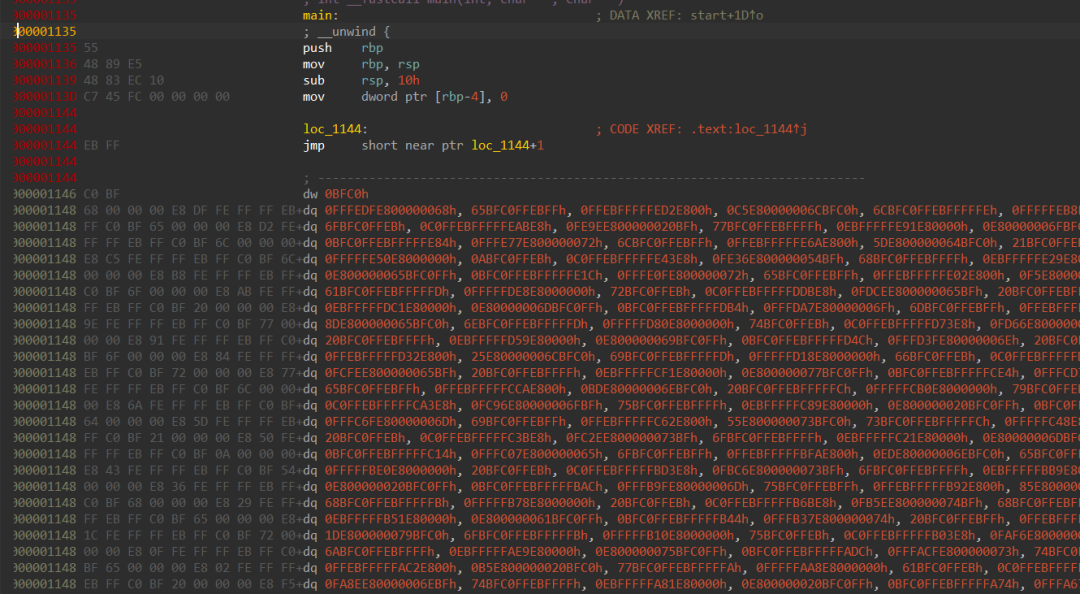
jmp花指令 分析main函数可以看到是杂乱字节,观察0x1144可以发现存在jmp db这种类型的花指令,因此可以写idapython脚本来解决
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
import ida_bytesimport ida_idadef patch (ea,num=1 ): for i in range (num): ida_bytes.patch_byte(ea+i,0x90 ) return print ("-----" )hexStr="EB FF C0 BF ?? 00 00 00 E8" bMask = bytes .fromhex(hexStr.replace('00' , '01' ).replace('??' , '00' )) bPattern = bytes .fromhex(hexStr.replace('??' , '00' )) signs=ida_bytes.BIN_SEARCH_FORWARD| ida_bytes.BIN_SEARCH_NOBREAK| ida_bytes.BIN_SEARCH_NOSHOW print (bMask,bPattern)begin_addr=0x1135 end_addr=0x3100 while begin_addr<end_addr: ea=ida_bytes.bin_search(begin_addr,end_addr,bPattern,bMask,1 ,signs) if ea == ida_idaapi.BADADDR: break else : print (hex (ea)) patch(ea,3 ) begin_addr=ea+8
参考链接:
https://blog.csdn.net/m0_51246873/article/details/127167749
https://www.cnblogs.com/YenKoc/p/14136012.html
https://www.xjx100.cn/news/40167.html?action=onClick
https://mp.weixin.qq.com/s/MUth1Qw-Fl2a5OrLw_2_0g
[https://skyi23.github.io/2024/11/11/IDA%20Python%20%E4%BD%BF%E7%94%A8%E6%80%BB%E7%BB%93/] (https://skyi23.github.io/2024/11/11/IDA Python 使用总结/)